상대의 기만까지 간파하는 AI 학습 기술 등장
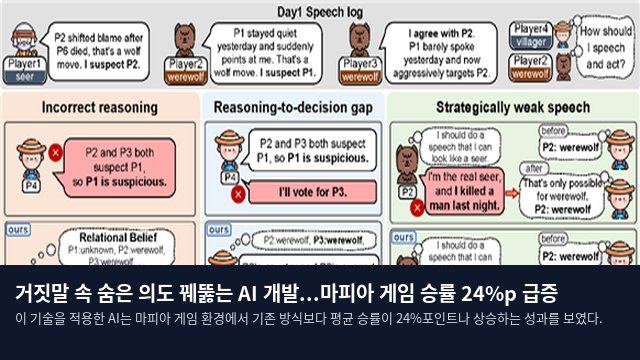
인공지능(AI)이 타인의 말을 무조건 신뢰하는 대신, 상대의 행동을 면밀히 분석해 숨겨진 의도와 관계까지 파악할 수 있도록 훈련하는 혁신적인 학습 기술이 공개됐다. 울산과학기술원(UNIST) 인공지능대학원 한승열 교수팀은 대형언어모델(LLM)이 타인의 역할과 목적을 직접 추론하고, 그 판단을 토대로 언어적·행동적 대응을 하도록 유도하는 '마르보(MARBO, Multi-Agent Relational Belief Optimization)' 기술을 개발했다고 1일 발표했다. 이 기술을 적용한 AI는 마피아 게임 환경에서 기존 방식보다 평균 승률이 24%포인트나 상승하는 성과를 보였다.
마르보는 다수의 AI 에이전트가 협동하거나 경쟁하는 과정에서 발생하는 정보 불균형과 의도적인 기만 상황을 극복하기 위해 설계되었다. 소통이 원활하지 않거나 상대가 정보를 왜곡할 때, AI가 상대의 숨은 정체와 의도를 파악해 자신의 목표를 달성하도록 돕는 것이 핵심이다. 이를 위해 AI는 축적된 대화 기록과 행동 양식을 분석하여 상대가 누구인지, 어떤 관계를 맺고 있는지 추론하는 '관계적 믿음'을 형성하도록 학습된다. 연구팀은 다양한 상황에 대응할 수 있도록 참여하는 AI들의 조합을 무작위로 변경하며 훈련의 다양성을 확보했다.
정교한 보상 체계로 학습 효율 극대화
기존의 학습 방식은 AI가 잘못된 추론을 했음에도 우연히 유리한 결과가 나오면 이를 긍정적인 신호로 오인해 잘못된 행동을 반복하게 만드는 한계가 있었다. 반면 마르보는 상대의 정체를 정확히 식별하고 목표에 부합하는 최적의 행동을 선택했을 때만 보상을 부여함으로써, 유사한 상황에서 올바른 판단을 내리도록 정교하게 설계되었다. 또한 AI가 발언할 때 단순히 상황에 맞는 말을 하는 것에 그치지 않고, 자신의 발언이 상대방의 판단에 어떤 영향을 미치고 자신에게 유리하게 작용하는지를 함께 고려하도록 가르친다.
게임을 통한 성능 검증 및 미래 확장성
연구팀은 사회적 추론이 필수적인 '웨어울프'와 '어몽어스' 게임을 통해 기술력을 입증했다. 70억 개의 매개변수를 가진 언어모델에 마르보를 적용해 다섯 종류의 상대 AI와 대결시킨 결과, 65.6%의 평균 승률을 기록했다. 이는 기존 방식의 승률인 41.6%보다 24%포인트 높은 수치이며, 매개변수가 두 배나 많은 모델이 기존 방식으로 기록한 64.0%보다도 우수한 성적이다. 어몽어스 실험에서도 20억 매개변수 모델은 승률이 36.4%에서 49.0%로, 40억 매개변수 모델은 40.0%에서 59.0%로 각각 크게 향상되었다.
한승열 교수는 이번 기술이 불완전하거나 속임수가 존재하는 환경에서도 AI가 관계를 추론하고 올바른 결정을 내리게 함으로써, 향후 자율 드론, 다중 로봇 시스템, 인간과 AI의 협업 분야에서 시스템의 신뢰도와 적응성을 높이는 핵심 기반이 될 것이라고 전망했다. 이번 연구 성과는 자연어 처리 분야의 세계적 권위 학술대회인 'EMNLP'에 채택되어 지난 10월 24일부터 29일까지 헝가리 부다페스트에서 개최된 학회에서 소개되었다.