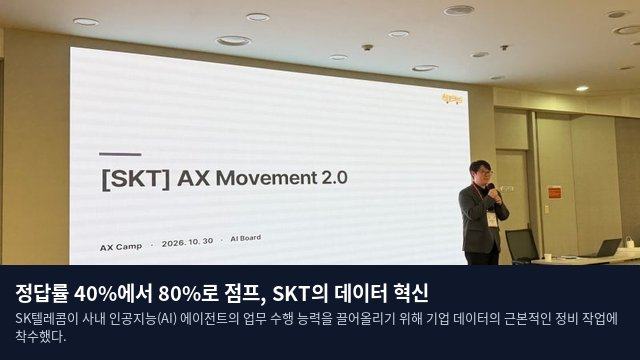
SK텔레콤이 사내 인공지능(AI) 에이전트의 업무 수행 능력을 끌어올리기 위해 기업 데이터의 근본적인 정비 작업에 착수했다. 기존 데이터 항목에 구체적인 업무적 의미와 상세 설명을 덧붙인 결과, AI 에이전트의 질문 답변 정확도가 기존 40% 수준에서 80% 이상으로 두 배 가까이 급증했다고 밝혔다.
데이터의 의미를 AI에게 학습시키다
지난 30일 경기도 이천시 소재 SK텔레콤 인재개발원에서 진행된 인공지능 전환(AX) 전략 발표에서 김인수 SK텔레콤 AI Board 팀장은 이러한 데이터 정비 성과를 상세히 공유했다. 그동안 기업들이 보유한 데이터는 주로 개발자나 기존 업무 시스템의 관행에 따라 관리되어 왔다. 이로 인해 데이터의 명칭이나 형식만으로는 실제 현업에서 해당 데이터가 어떤 맥락으로 쓰이는지 파악하는 데 한계가 있었다.
인간은 축적된 경험을 통해 데이터의 함축적 의미를 이해할 수 있지만, AI 에이전트는 데이터의 실제 용도를 정확히 해석하지 못하는 경우가 많다. 따라서 AI를 실무에 배치하기 위해서는 모델 자체의 성능 향상뿐 아니라, AI가 데이터를 직관적으로 이해할 수 있도록 정비하는 과정이 필수적이다. SK텔레콤이 선보인 '데이터 데스크(Data Desk)'는 바로 이러한 사내 데이터 항목에 업무적 맥락과 설명을 부여하는 핵심 기술이다.
김 팀장은 데이터 정비 전후의 성능 차이를 언급하며, AI 모델을 교체하거나 에이전트의 수를 늘리는 방식 외에도 기존 데이터의 의미를 체계화하는 것만으로도 업무 정확도를 획기적으로 개선할 수 있음을 증명했다고 설명했다.
방대한 DB 관리와 운영 비용의 최적화
이번 실험에 적용된 네트워크 관련 데이터베이스(DB)는 9,000개가 넘으며, 관리 대상인 데이터 항목은 약 30만 개에 달한다. 이처럼 거대한 규모의 데이터를 AI 에이전트가 원활히 활용하려면 정보의 탐색과 해석 능력은 물론, 데이터 처리 과정에서 발생하는 비용 관리도 중요한 과제다. SK텔레콤은 운영 효율을 극대화하기 위해 자체 AI 모델을 도입하여 업무 성격에 맞춰 모델을 적절히 배분하는 전략을 취하고 있다.
사내 AI 에이전트의 보급이 가속화되면서 비용 효율성에 대한 검토도 심화되고 있다. 김 팀장에 따르면 한때 7,000개에 육박했던 사내 AI 에이전트는 현재 약 1,500개가 정기적으로 가동 중이다. 회사는 각 에이전트가 창출하는 실질적 성과를 분석하여, 투입되는 토큰 비용 대비 효용성이 충분한지를 면밀히 평가하고 있다. 그는 단순한 규모 축소가 아니라 성과 중심의 운영을 목표로 하고 있으며, 평가 결과에 따라 에이전트의 생성과 축소가 유동적으로 이루어질 것이라고 덧붙였다.
보안 기술 개발과 조직적 성과 창출
AI 에이전트가 사내 데이터를 폭넓게 다루는 과정에서 발생할 수 있는 개인정보 및 민감 정보 유출 우려를 해소하기 위한 기술적 장치도 마련되었다. SK텔레콤은 민감한 원문 데이터를 AI에 직접 노출하지 않고 가공된 처리 결과값만 전달하는 'Z.E.Z(Zero Exposure Zone)' 기술을 개발해 특허를 출원했다. 이는 AI가 업무에 필요한 정보를 활용하면서도 원본 데이터에는 접근할 수 없도록 차단하는 보안 체계다.
또한, 직원의 업무 흐름을 AI가 인지할 수 있는 형태로 구조화하는 '워크맵(Work Map)' 기술 개발도 병행 중이다. 이는 기존 자료를 분석해 업무 절차를 도출하고, AI 에이전트가 대체하거나 지원할 수 있는 영역을 발굴하는 기술이다. 개별 직원이 해결하기 어려운 시스템 연계 및 보안 문제를 해결하기 위해 'AX 이네이블러 태스크포스(TF)'도 가동하고 있다. 김 팀장은 개인 차원의 과제 해결을 넘어 이제는 조직 차원의 지원을 통해 실질적인 성과를 도출하는 단계로 진화하고 있다고 강조했다.